
英特尔携手腾讯云:软硬件联合调优,面向智能体重构云基础设施
作者: 李祥敬
责任编辑: 李祥敬
来源: CBISMB
时间: 2026-11-09 17:45
浏览: 0
点赞: 0
收藏: 0
过去两年,AI算力的讨论高度集中在加速器上。业界默认的服务器架构是CPU与GPU按1:8配置,CPU承担数据搬运与请求转发,计算主体交给GPU。这一判断在单次推理场景中成立,但在智能体(Agentic AI)进入生产环境之后,开始出现明显的偏差。
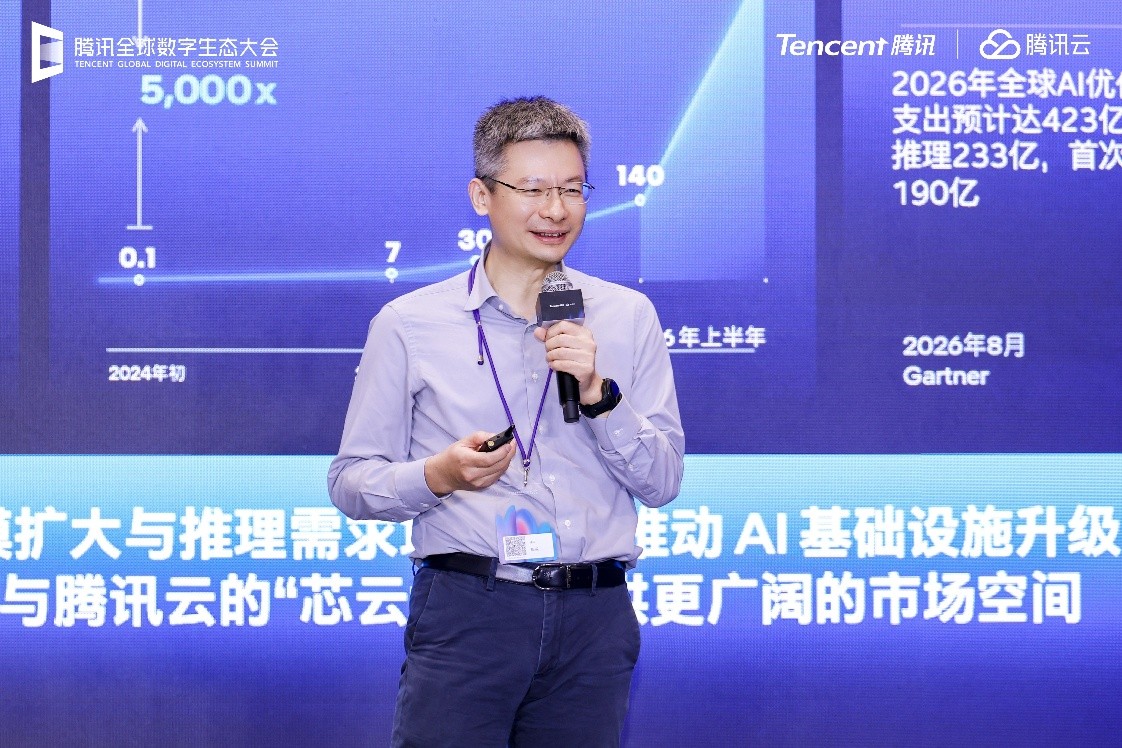
2026年10月29日,腾讯全球数字生态大会英特尔专场以“智启Agent·算筑中枢”为主题,英特尔与腾讯云的技术团队分别从硬件定义与业务实践两端,给出了同一组结论:智能体不是把大模型做大,而是把任务做长。任务变长之后,编排、调度、状态维护、工具调用、安全治理这些工作落在CPU上,CPU在AI基础设施中的权重随之上升,CPU与GPU的配比从过去的1:8向1:1演进。这一变化不是产品宣传口径,而是负载结构变化的结果。
一、负载侧的事实:从单次推理到循环执行
英特尔给出的行业判断包括三组数据。国内大模型日均Token调用量两年增长5000倍,近六个月再增长3倍,当前规模达到日均500万亿Token。全球数据中心负载预计到2030年较2025年翻倍,其中传统基础业务仍占约一半;x86服务器装机量稳步上行,2030年预计达到7600万台,占全球服务器装机接近八成。AI负载内部结构也在位移,未来推理占AI负载约37%,训练占13%,推理的增量主要由智能体应用带来。
两类AI计算模式的差异决定了硬件需求的分化。单轮问答推理的开销集中在Token生成阶段,属于密集计算,GPU主导,CPU只在请求前后做处理。智能体执行的是思考、规划、行动、反思的循环链路,每一步都包含条件判断、外部工具调用、结果读取与状态保存,CPU与GPU交替协同完成业务闭环。腾讯云方面对业务侧的观察与之吻合:Agent业务关注的重点不是峰值算力,而是编排复杂度、可观测性、弹性伸缩,以及CPU与GPU在不同阶段的资源匹配。
由此产生三个具体约束:CPU负载呈突发式波动,瞬时拉起大量执行单元;单个Agent实例常驻内存约1GB,内存容量成为部署密度的上限;智能体是有状态应用,会话记忆与KV Cache持续累积,对存储吞吐和延迟提出新的要求。
二、英特尔的硬件回应
围绕智能体全生命周期,英特尔在四个环节上做了产品安排。
CPU方面,至强6性能核与至强6+能效核已进入商用,后者基于18A制程。面向下一阶段,专门为智能体基础设施设计的Diamond Rapids已明确规格,最高256核,支持AMX与AVX10.2指令集,配置大容量末级缓存、MRDIMM内存与更高的双向I/O带宽。这一代产品的设计逻辑是把高并发、大内存占用、频繁上下文切换作为主要假设,而不是按传统通用计算负载来定义。
存储方面,针对有状态应用带来的KV Cache压力,英特尔推出基于至强6的存储平台,采用存算分离架构配合RDMA互联,通过KV-Shrink软件做分层管理,把KV Cache下沉至后端高性能存储。在32B参数规模的主流开源模型上测试,KV Cache全部命中后端存储时,首Token时延下降90%;并发8至32的场景下吞吐量提升5至8倍。开启QAT硬件压缩后,吞吐基本无损失,可用存储容量提升近20%。单机24盘配置在优化后可达到2.7M IOPS,对应智能体小I/O、高并发、低延迟的访问特征。
内存方面,两条路径并行。其一是软硬协同,Zswap机制叠加IAA内存压缩加速器,压缩比达到2.1倍,压缩与解压速度较纯软件方案分别提升11倍和12倍;其二是物理扩容,通过2DPC内存插槽与CXL内存扩展抬高单机内存上限。安全方面,从第四代至强延续至下一代平台的SGX与TDX机密计算能力保留,用于智能体上下文、身份校验与外部接口访问的隔离。
GPU方面,B60与B70依靠大显存承接图像生成类业务;新一代GPU D系列(Crescent Island)单卡最高480GB LPDDR5X显存,功耗约350W,风冷部署,单卡可承载3000亿参数模型,八卡集群支持万亿参数,主要指向Agent推理中的显存占用问题。软件侧提供SYCL工具链,并以智能体辅助完成CUDA代码迁移,缩短迁移周期。
端侧方面,英特尔提出混合AI的框架:推理阶段可放在云端,涉及本地文件与外设操作、对时延和隐私敏感的执行阶段放在终端。第三代酷睿Ultra与Wildcat Lake构成硬件底座,高端机型可在本地运行350亿参数级模型,中低端机型承载Marvis、WorkBuddy等办公智能体。终端从被人操作的工具,转向由智能体驱动的执行环境。
三、腾讯云的生产验证
硬件规格给出上限,真实约束来自操作系统、虚拟化、沙箱与数据链路。腾讯云的分享集中在四块业务实践。
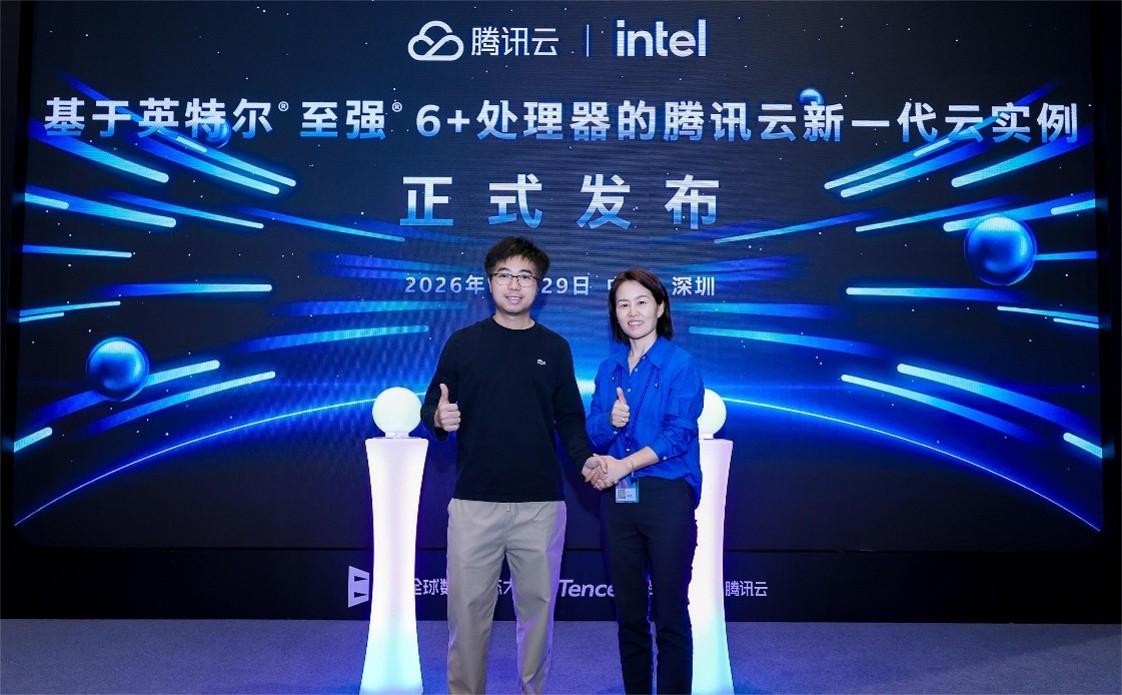
云服务器CVM。腾讯云把AI时代的CPU云服务器划分为Agent运行、数据处理、后训练、CPU推理四类场景,GPU资源主要投向训练。底层依托星星海定制服务器与自研TencentOS调优,虚拟化组件支持端到端热升级与大规格实例无感知热迁移。现有产品中,S9e与S9 Pro基于至强6性能核,全核3.6GHz、200G网络,性能较上代提升10%至20%;S9基于至强6能效核,vCPU与物理核1:1映射,集成QAT与vPMU,为腾讯自研架构独家售卖。基于至强6+的新一代实例综合性能提升约30%,将先经内部业务验证再对外提供服务;在沙箱创建200ms的SLA约束下,并发密度高于竞品45%,单vCPU沙箱吞吐提升94%,并结合TDX构建智能体全生命周期的安全防护。更远期规划指向Diamond Rapids平台。
沙箱引擎CubeSandbox。智能体执行需要隔离环境,但容器隔离强度不足,传统虚拟机开销过大。腾讯开源的CubeSandbox采用MicroVM加快照资源复用:同一镜像批量启动时只读内存共享,仅修改页占用额外空间,从而获得高于传统容器的部署密度,同时保留算力弹性(快速创建与销毁)与状态弹性(暂停、克隆、回滚)。该平台同时支撑云函数与大模型强化学习训练。在与英特尔联合优化OpenCloudOS内核与沙箱启动路径之后,200ms时延约束下单机可支撑350个沙箱并发,密度为竞品的1.46倍,宿主机混跑其他业务时创建时延保持平稳。生产环境的负载特征会持续反馈至英特尔的CPU设计环节。
多模态数据链路Xpark。智能体的轨迹数据与大模型训练语料以图文音视频为主,传统Spark难以适配Embedding、OCR、抽帧等AI原生算子,CPU与GPU的异构调度容易形成阻塞。腾讯自研的Xpark定位于AI原生的数据处理引擎,面向训练数据制备、Agent轨迹分析、RAG、自动驾驶与具身智能。其能力包括:多模态算子库配合大小模型级联,最多减少70%的大模型调用;CPU与GPU异步就近调度,对比开源Data-Juicer性能提升3倍;调用至强平台AMX指令集,用闲置CPU资源承担推理,图像评分性能较AVX-512提升3.4倍,文本Embedding提升2.4倍;iVTAL加速库用于视频转码,性能高于开源PyAV 1.5倍;分布式算子方面,MinHash较开源方案快8.5倍,精确子串去重较Text-dedup快47.8倍。该引擎目前用于处理WorkBuddy的用户轨迹数据并支撑意图识别。
内存高密部署。腾讯操作系统团队最初采用LZ4与ZSTD做软件内存压缩,单路解压可接受,高并发下解压路径争抢内存带宽,最大时延升至5毫秒,无法进入业务关键路径。接入IAA加速器并在内核层裁剪驱动、选定IAA-batch-8配置后,单路解压性能较LZ4提升12倍,256路并发下解压时延维持在微秒级;综合业务压力测试中平均时延提升16倍,最大时延提升9倍,在控制性能损耗的前提下抬升了容器部署密度。
四、协同设计与仍未解决的问题
英特尔与腾讯的合作覆盖四个层面。基础设施层面,双方联合迭代多代至强云实例,重构异构服务器架构,依托QAT完成混元大模型KV Cache的分级存储与成本优化。软件层面,联合调优CubeSandbox与OpenCloudOS内核,完成混元系列模型在x86与酷睿Ultra平台的适配,混元MT翻译模型经算子优化后落地B站直播弹幕翻译。终端层面,推动WorkBuddy与Marvis在AI PC上以本地或混合模式运行,并联合华硕、机械革命、飞牛等厂商把端侧智能体带入商用PC与AI NAS产品。
需要指出的是,现场技术人员的表述保持了克制。现有软硬件尚不能完全覆盖智能体的全部需求,大量边界条件与异常路径需要在生产环境中继续暴露。CPU与GPU的1:1是场景演化的方向,而不是固定标准,不同业务与部署架构下的合理配比差异很大。内存容量、沙箱并发峰值、长上下文带来的存储膨胀,仍然是未解的问题。
从产业角度看,智能体的普及改变的是算力评估的维度。此前主要看芯片的计算峰值,现在需要同时衡量CPU处理突发与分支任务的能力、硬件加速器对内存与压缩开销的削减、存储在KV Cache吞吐上的承接能力,以及端云分工对成本与隐私的平衡。芯片厂商需要理解上层负载,云厂商需要把业务痛点向上传递并参与硬件定义,这种双向的协同设计正在成为AI基础设施的常规工作方式。
智能体的规模化只是开始。能否稳定处理思考、规划、执行、记忆与安全这一整套闭环,将决定各家在这一轮基础设施竞争中的位置。


 京公网安备:11010502051901号