
Agentic AI时代CPU重回C位:英特尔重构AI基础设施底座
作者: 李祥敬
责任编辑: 李祥敬
来源: CBISMB
时间: 2026-09-29 13:53
浏览: 0
点赞: 0
收藏: 0
当智能体(Agentic AI)正在改写数据中心工作负载结构,CPU被GPU遮蔽的光芒正在显露。同时,AI能力不再局限于单点芯片算力,而是依靠端‑边‑云完整链路的连接与协同,把模型、数据、硬件、开发者与行业业务打通,实现智能体从实验室原型走向大规模生产落地。

在苏州举办的2026英特尔技术创新与产业生态大会上,英特尔首席营销与传播官Annie Shea Weckesser在主旨演讲中提出三大核心战略:覆盖PC、边缘、数据中心的开放计算平台;面向特定工作负载的定制化芯片;依托先进制程与封装实现复杂异构系统集成。
一、负载范式迁移:智能体时代,CPU价值重回架构核心
生成式AI阶段,行业基础设施的焦点集中在GPU模型生成能力,数据中心评价标尺围绕Token输出能力展开。但Agentic AI带来的是完全不同的工作流:智能体不再是被动问答,它包含上下文工程、工具调用、循环校验迭代,要完成规划、检索、推理、工具调用、结果校验的完整闭环,大量编排、调度、沙箱隔离、数据预处理、记忆管理工作,并不适合GPU,而是CPU的典型工作场景。
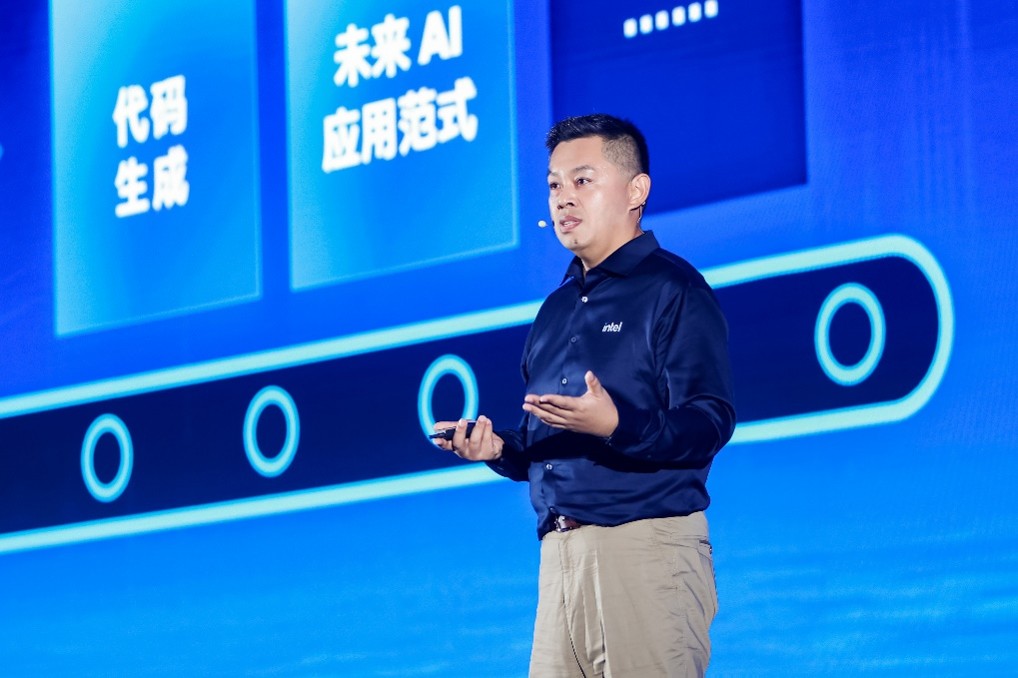
英特尔数据中心集团副总裁、中国区总经理陈葆立引用一组产业数据,印证这场结构性变革。市场预测,2026年底超过80%企业应用将嵌入至少一个AI智能体;IDC预计,到2031年,中国企业场景活跃智能体数量将达到3.5亿。国内大模型每日Token调用量已经达到2024年初的5000倍;美银证券预估,2029年中国AI数据中心固定资产投资将突破2.2万亿元。
需求爆发直接改写硬件市场预期:仅仅半年时间,市场机构对2030年数据中心CPU市场规模预测,从590亿美元上调至2100亿美元,增长3.6倍;数据中心AI负载占比预计将从2025年40%攀升至2030年80%。英特尔判断,AI工作负载推动CPU与GPU配比,从过去传统的4:1,逐步向接近1:1演进,CPU不再只是GPU的配套“机头”,而是整个AI系统的调度中枢。
“数据中心的架构必须随智能体AI而变。一个智能体从思考到执行,牵动的是模型推理、任务编排、数据搬运与记忆管理的完整链路。全新的智算中心,应该以CPU为核心,CPU、GPU、IPU、存储协同运作,而不是单纯比拼某一环节的参数。”陈葆立这样总结。
基于这一判断,英特尔从“Token工厂”视角升级为“AI工厂”的全新架构理念。未来的数据中心将由三类集群协同组成,并且依赖CPU完成数据调度:
- CPU服务器/CPU集群:承担智能体实例运行、任务编排、沙箱管理;
- GPU智算集群:也就是传统Token工厂,负责大模型推理、矩阵计算;
- 高性能存储集群:保存长对话、文档、中间状态、KV Cache等海量智能体生成数据。
衡量基础设施好坏,不再看硬件标称总算力,而是在既定电力、预算约束下,系统能够稳定完成多少有效业务任务,系统整体效率优先级高于单卡峰值算力。
二、至强6+:面向智能体密度优化的硬件底座与实测表现
为承接智能体高密度并发、沙箱大规模启停、复杂编排调度的新负载,英特尔推出基于Intel 18A制程的至强6+处理器,单颗处理器最高288核,配套智能体套件,单颗芯片可稳定部署接近1000个智能体实例。
英特尔定义了衡量智能体CPU平台的两大核心维度:单CPU可承载智能体数量、单个智能体运行性能,而不是简单统计核心数。大会披露两组国内客户真实环境实测结果:
- 在SWE‑bench基准测试场景,至强6+单智能体平均性能领先竞品15%;
- 在200ms沙箱启动SLA约束条件下,单颗处理器可支持350个沙箱并发创建,性能达到竞品的1.46倍,解决云端大批量智能体隔离环境快速拉起的业务痛点。
单芯片性能只是起点。海量业务场景下,瞬时成千上万个沙箱同时启动,考验的是整机柜层面计算、内存、供电、散热的综合协同,而非单颗CPU极限。
为此,英特尔联合国内OEM、液冷厂商,正式发布开放Agent整机柜平台规范,输出面向智能体负载的整机柜硬件参考标准,开放给全行业厂商,推动标准化CPU整机柜集群落地,把智能体能力从芯片延伸到机房基础设施层面。
同时,至强系列继续承担GPU服务器主流机头CPU角色。智能体业务会大量处理网页、PDF、音视频等异构原始数据,素材解析、提取、预处理工作由至强完成,释放GPU资源专注模型运算。依托内置AMX矩阵加速,数据向量化性能达到基准2倍,重排序性能达到基准4倍,已经在国内多家互联网厂商业务落地。
三、打通数据通路,英特尔与合作伙伴破解推理瓶颈
长上下文、多智能体并发,带来推理侧新的挑战。随着百万Token上下文成为开源大模型的标配,35B参数模型100万Token上下文对应的KV Cache可达300GB,远超GPU HBM显存物理上限,大量数据需要在GPU、内存、SSD之间来回流转,一旦数据通路阻塞,昂贵的GPU算力就会空等数据,直接拉高业务TCO。
英特尔的解决思路不是单纯堆存储硬件,而是以CPU为调度核心,打造分层、可加速的完整KV Cache软件‑硬件体系:
- KV Cache智能加速套件:依托至强内置QAT压缩、DSA数据搬运加速引擎,可对KV Cache做无损压缩,同时加速数据搬移;实测中,KV Cache传输速率最高提升9.66倍,首字时延TTFT最高提升15倍。
- G3.5共享KV Cache存储池方案:联合产业伙伴构建内存扩展池,把部分KV Cache卸载到内存与高速存储,平衡容量、成本与性能。
- 生态联合落地:与焱融科技合作,基于至强6+MRDIMM内存打造全闪存储系统,焱融F9000X Turbo在MLPerf Storage v3.0测试的Llama3检查点读写、3D‑Unet训练两项拿到全球第一;与忆联合作推出分层KV Cache实践方案,以至强6搭配UH812a企业级SSD,实现冷热KV Cache分层部署。
这套方案清晰体现英特尔系统级思路:CPU不只是计算单元,同时充当存储、缓存、加速器之间的调度枢纽,打通“算力‑内存‑存储”整条数据通路。
四、异构产品矩阵与软件生态协同
Annie Shea Weckesser演讲披露英特尔制程路线:Intel 18A已经实现量产,高性能版本Intel 18A‑P进入风险试产;Intel 14A进展顺利,面向内部产品风险试产计划2027下半年启动,目标2028大规模量产爬坡。EMIB、EMIB‑T先进封装技术,实现多计算引擎、IP在单封装内集成,保障异构芯片之间高速数据流转,为数据中心、端侧各类AI产品打下底层工艺基础。
代号Crescent Island的Xe3P架构GPU在大会进一步对外披露,产品专门针对Agentic AI推理场景设计,采用LPDDR5X,最高可配置480GB超大显存,可承载超长上下文KV Cache驻留;整卡功耗350W,支持现有风冷机房部署,无需大规模液冷改造。软件层面完整适配主流开源大模型,更多产品细节将在2026年晚些时候对外释放。
智能体基础设施,硬件只是一半,软件栈决定落地效率。英特尔持续深度参与PyTorch、vLLM、SGlang等主流AI开源项目,贡献Agentic AI相关能力,推动硬件与开源框架适配。同时面向云厂商提供定制化芯片合作路径,针对超大规模客户的差异化工作负载需求,开放架构、IP、先进封装、制造能力,联合开发定制芯片。
结语
纵观本次大会,英特尔提出了一套面向Agentic AI的系统方法论。
智能体时代远未定型,技术路线仍在百家争鸣。但有一点已经明确:未来AI基础设施的竞争,已经从单一芯片参数的比拼,演进到系统与生态的综合较量。


 京公网安备:11010502051901号