
Mistral发布Voxtral 3:语音智能体进入亚秒级多步骤交互
作者: CBISMB
责任编辑: 宫建强
来源: Mistral官方公告
时间: 2026-10-22 15:14
浏览: 0
点赞: 0
收藏: 0
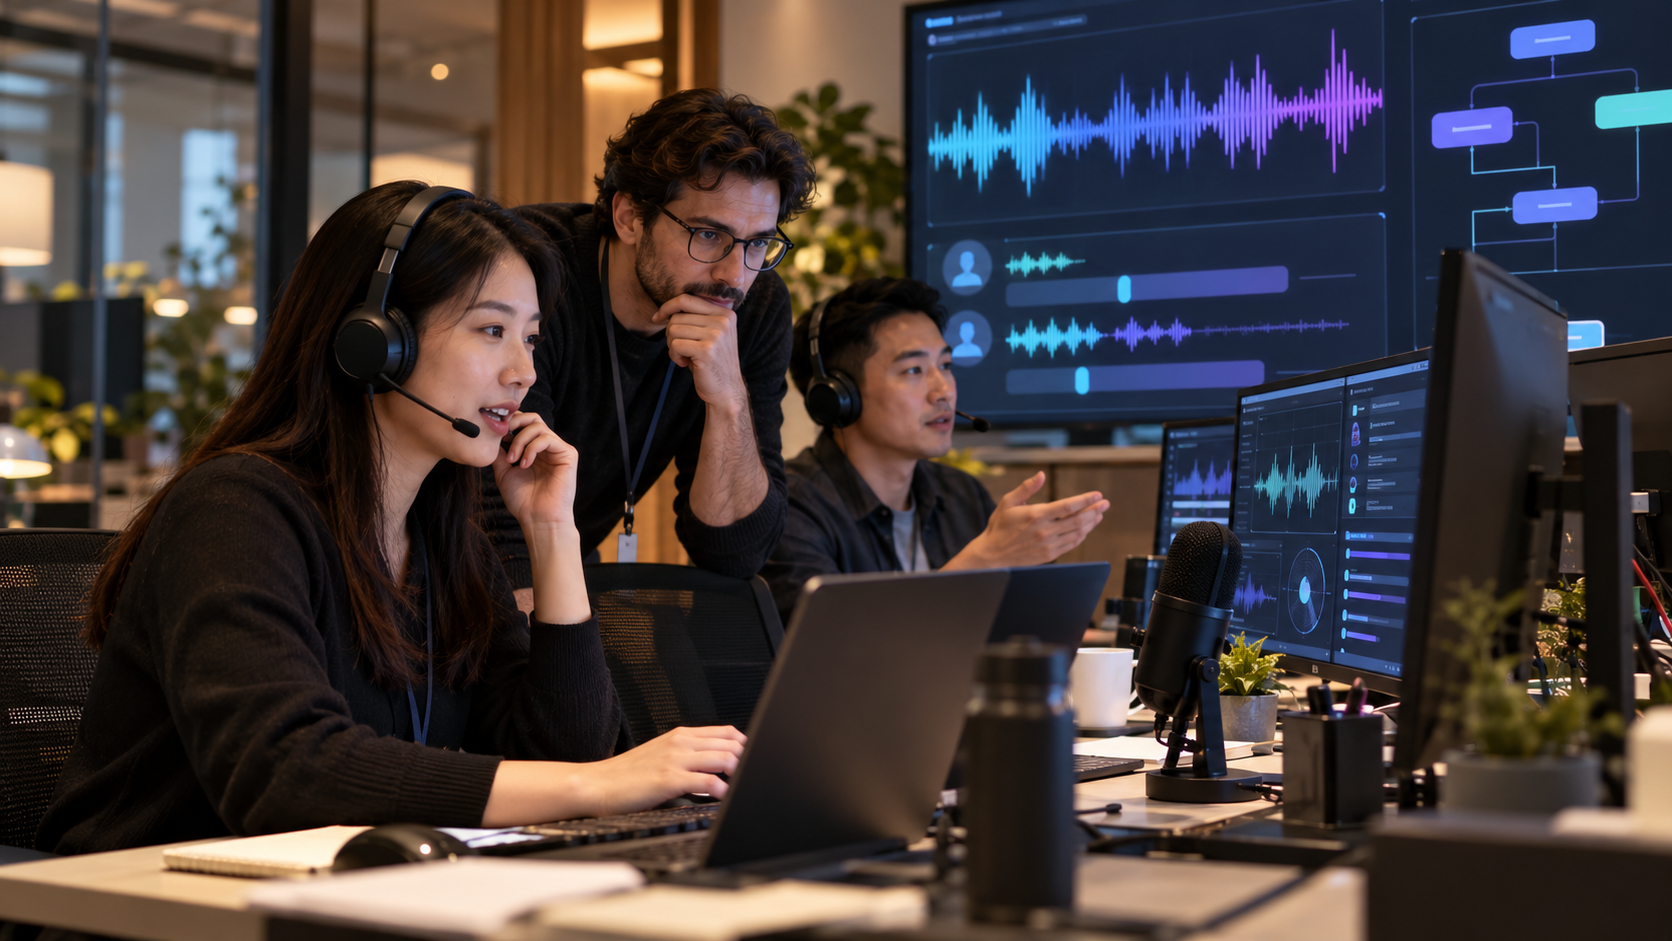
传统语音机器人常被停顿、口音和用户插话打断,也很难跨系统完成真正的业务流程。Mistral推出Voxtral 3后,语音AI正在从听写工具变成能够连续办事的智能体。
10月20日,Mistral发布Voxtral 3语音模型家族及Voice Agent SDK。它把语音输入、推理、工具调用和语音输出连接成一条实时流式管线,面向客服中心、服务台、虚拟助手和免手持协作工具等场景。
听、想、说和行动同时衔接
按照官方架构,Voxtral Mini Transcribe Realtime 3负责监听并判断用户是否说完,通用模型负责理解意图、规划和调用工具,Voxtral Speech 3再用与对话相符的语气回应。各阶段独立运行并以流式方式衔接,不必等待前一步完全结束。
Mistral称,一轮交互可以在一秒以内完成,当用户插话时,系统能够停止播报并重新监听。这一体验对于预约、账单查询和身份验证等电话流程尤其重要。不过,亚秒级属于厂商公布的目标表现,实际速度还取决于网络、所选模型、工具接口和业务系统响应时间。
语音智能体可以直接连接业务工具
在通话中,智能体可以通过函数调用、网页搜索和企业内部检索执行多步骤任务,例如核验身份、查看账单或预约服务。SDK支持SIP电话呼入与呼出,也可通过WebRTC运行在浏览器和应用中,并连接现有电话、IVR和客服中心软件。
这让语音交互不再只是把声音转换成文字,而是可以读取系统状态、提交操作并确认结果。与此同时,工具权限也成为新的风险点:能够查账单的智能体不应自动获得退款权限,能够预约的智能体也需要防止重复下单和越权修改。
覆盖50多种语言,组件可以分别替换
Voxtral 3整体支持50多种语言。实时转写模型支持40多种语言和低于500毫秒的可配置转写延迟,并集成轮次结束检测、上下文偏置和说话人区分。语音合成模型覆盖35种以上语言和50多种方言,强调情绪与表达控制。
语音识别、推理模型和语音合成是相互独立的组件。企业可以更换中间的大语言模型、声音或语言,而不必重写整套应用。这种模块化有利于逐步升级,也方便将高风险流程保留在更可控的模型和规则下。
提供API与本地部署选择
Voxtral 3可通过Mistral在欧洲、美国和全球提供的API使用,也可以部署在企业自有基础设施中。官方公布的API价格包括:批量转写每分钟0.0035美元起,实时转写每分钟0.008美元,Voxtral Speech 3每100万字符13美元。价格和区域可用性可能调整,部署前应以最新页面为准。
对于金融、医疗和政府等场景,音频往往包含身份、健康和交易信息。本地或私有云部署提供了数据控制选项,但企业仍需要设置录音保留期限、访问审计、敏感信息脱敏和用户告知机制。
编辑观察:自然对话之后是操作安全
语音智能体的体验不只取决于声音是否自然,还取决于是否准确听懂姓名、编号、日期和否定表达。一个小的转写错误可能导致错误预约或账户操作,因此关键字段应复述确认,高风险动作应增加二次验证。
企业试点时可以先从查询类任务开始,再逐步开放写入和交易权限;同时记录转写准确率、任务成功率、人工接管率和用户插话后的恢复表现。当语音系统能够解释自己做了什么、保留操作记录并在不确定时转人工,亚秒级响应才真正具有业务价值。
配图为AIcent原创AI生成实景风格示意图,非官方新闻现场照片,不使用第三方新闻图片。
参考来源:Mistral官方公告(2026年10月20日)。正文为基于官方消息的中文整理,编辑观察与事实披露分开呈现。


 京公网安备:11010502051901号