
AWS用AI解读1300份病毒基因组:从序列中寻找疾病线索
作者: CBISMB
责任编辑: 宫建强
来源: AWS公共部门官方博客
时间: 2026-10-26 10:19
浏览: 0
点赞: 0
收藏: 0
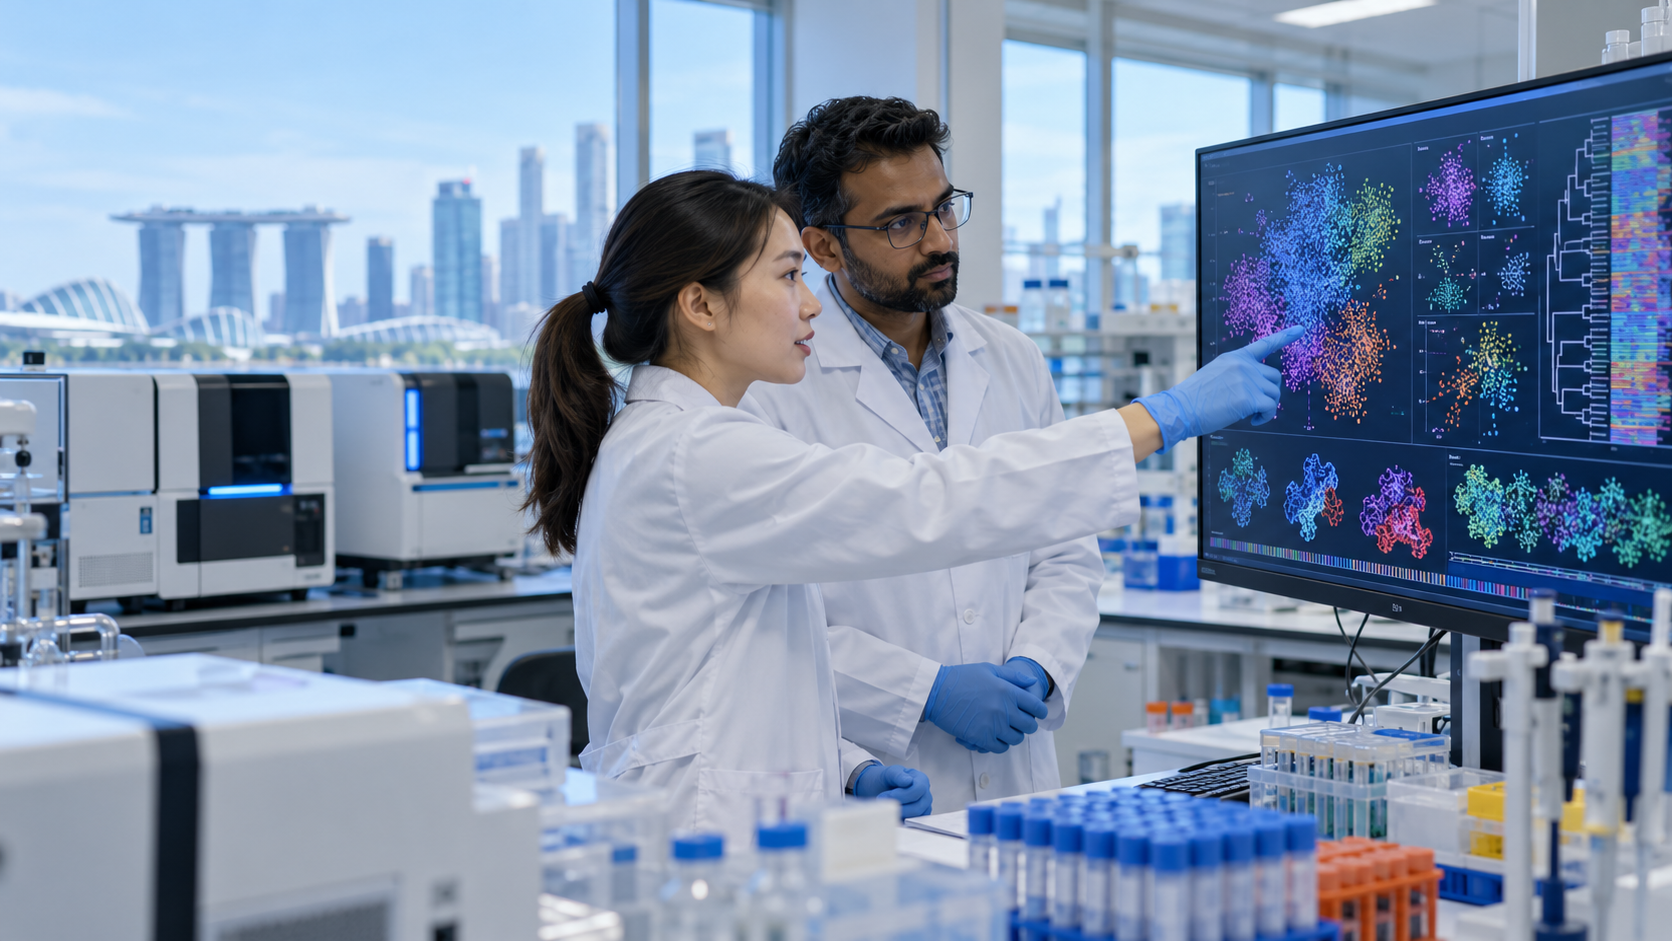
AI正在把基因序列变成可以比较的数字地图。研究人员不再只靠人工逐段检查海量序列,而是先让基础模型提取特征,再寻找可能与疾病相关的群组和异常信号。
10月25日,AWS公共部门博客介绍了一项由国家级基因组研究机构、Temus与AWS合作完成的概念验证。项目聚焦EB病毒(EBV)基因组,希望探索不同病毒株与鼻咽癌、健康对照、样本类型和地理来源之间是否存在值得进一步研究的结构。
先把长序列转换成“可计算的表征”
全长病毒基因组体量大、结构复杂,原始FASTQ数据还可能包含数千万条短序列。团队先用生物信息学工具提取相关EBV片段、去重并抽样,降低后续AI分析的计算压力。随后选用开源基因组基础模型Evo 2,把序列转换为高维数字嵌入。
这些嵌入并不是诊断结论,更像一张由模型绘制的特征地图。研究团队先用主成分分析降低维度,再用HDBSCAN进行无监督聚类。该算法不要求预先指定群组数量,适合处理密度不均、结构未知的数据;最后再用UMAP把复杂关系投射到便于观察的空间中。
模型找到了结构,但还没有证明因果
在超过1300份EBV基因组样本中,概念验证得到多个彼此分离的聚类。AWS披露,不同疾病标签相关群组的纯度约为69%至97%,部分关键群组中主导疾病类型的平均归属概率超过0.85。团队还观察到鼻咽癌、健康对照以及伯基特淋巴瘤相关样本的候选结构。
这些数字来自合作团队的概念验证,并不代表模型已经能够用于筛查、诊断或预测个体风险。聚类可能受到样本来源、测序流程、地域结构和数据不平衡影响。官方也明确提出,下一步需要在更大、独立的队列中重复结果,并用其他基因组模型交叉验证。
云端算力只是研究链条的一部分
项目使用Amazon S3保存样本、元数据和分析产物,并通过配备NVIDIA H200与L40 GPU的Amazon EC2实例处理全长序列。身份认证采用IAM角色,网络访问由VPC安全组限制。对于基因组数据,技术能力之外还必须考虑伦理审批、去标识化、访问最小化和研究用途边界。
编辑观察:让AI负责筛线索,让实验负责作结论
基因组基础模型的价值,是在人工难以穷尽的组合中快速缩小搜索范围。它可以提示哪些样本值得复查、哪些特征可能形成新假设,但不能替代实验验证、临床研究和专业判断。
更可靠的科研AI流程应保留数据版本、预处理参数、模型版本和聚类结果,允许其他团队复现;同时设置对照实验,判断信号究竟来自生物差异还是数据处理方式。只有候选线索在独立样本中稳定出现,并能获得生物学解释,才可能逐步走向实际研究价值。
配图为AIcent原创AI生成实景风格示意图,非官方新闻现场照片,不使用第三方新闻图片。
参考来源:AWS公共部门官方博客(2026年10月25日)。正文为基于官方消息的中文整理,编辑观察与事实披露分开呈现。


 京公网安备:11010502051901号